Muse Wonder od Mety: test, ceny i benchmarki
Muse Wonder kosztuje tyle co Claude Opus 5.5 i działa z Polski. Benchmarki Mety i niezależne, ceny, dostęp krok po kroku oraz mój test po polsku.
Muse Wonder to najmocniejszy model językowy Mety udostępniony przez API, wydany 12 października 2026 roku razem z jeszcze mocniejszym wariantem Muse Wonder Full. Kosztuje 4 USD za milion tokenów na wejściu i 20 USD na wyjściu, czyli dokładnie tyle co Claude Opus 5.5. Z Polski najprościej użyć go przez OpenRoutera (na nim robiłem test) albo w Cursorze, a polityka Meta Model API nie wyklucza Polski. W moim teście po polsku zbudował poprawną aplikację z jednego polecenia 2,5 raza szybciej niż Opus 5.5 i GPT-6 Astra, za 0,22 USD. W trudniejszych benchmarkach kodowania Opus 5.5 nadal jest wyraźnie lepszy.
To trzeci duży krok Mety od lipca. W lipcu firma uruchomiła płatne API z modelem Muse Spark (pisałem o tym tutaj), w sierpniu wypuściła otwarte wagi Muse Glimmer (szczegóły), a teraz celuje w ścisłą czołówkę, obok Opusa 5.5, Claude Fable 5.1 i GPT-6 Astry.
Muse Wonder i Muse Wonder Full: gdzie są dostępne
| Muse Wonder | Muse Wonder Full | |
|---|---|---|
| Identyfikator w API | muse-wonder-1.0 |
brak dostępu przez API |
| Gdzie działa | Meta Model API, OpenRouter, Cursor, Muse Code (każdy plan) | tylko Muse Code, plany Power i Maximum |
| Cena | 4 USD / 20 USD za 1 mln tokenów | w abonamencie od 50 USD miesięcznie |
| Okno kontekstu | 1 mln tokenów | 1 mln tokenów |
Oba modele przyjmują tekst, obrazy i wideo, a odpowiadają tekstem. Okno kontekstu ma milion tokenów i Meta nie dolicza nic za jego zapełnienie: stawka jest ta sama przy prawie pustym i prawie pełnym kontekście. Model ma sześć poziomów rozumowania, od minimal do max, a najwyższy kosztuje tyle samo za token co pozostałe (zużywa po prostu więcej tokenów). Ustawienie max w API nie zamienia zwykłego Wondera w wersję Full. Wag do pobrania nie ma, to model zamknięty.
Benchmarki według Mety
Meta zestawiła oba warianty z Fable 5.1, GPT-6 Astrą i Opusem 5.5. Wszystkie modele działały na maksymalnym poziomie rozumowania. Pogrubiłem najlepszy wynik w każdym wierszu.
| Benchmark | Wonder Full | Wonder | Fable 5.1 | GPT-6 Astra | Opus 5.5 |
|---|---|---|---|---|---|
| Personal Superintelligence Index (wewnętrzny) | 59,1 | 54,3 | 49,9 | 54,5 | 55,2 |
| Harvey LAB-AA (prawo) | 13,1 | 10,0 | 6,4 | 8,6 | 4,2 |
| Vals Finance Agent V2 | 59,1 | 56,6 | 58,9 | 53,5 | 58,6 |
| HealthBench Pro | 62,3 | 60,5 | 62,1 | 65,3 | 65,6 |
| AutomationBench-AA | 45,4 | 39,1 | 32,1 | 41,6 | 41,2 |
| GDP.pdf | 33,2 | 30,8 | 27,6 | 34,2 | 30,6 |
| JobBench | 75,3 | 70,5 | 73,1 | 66,1 | 75,4 |
| OSWorld V2.1 (częściowo) | 78,4 | 72,6 | 80,7 | 75,8 | 81,8 |
| MemoryBench (wewnętrzny) | 85,5 | 85,6 | 79,0 | 81,4 | 81,5 |
| Terminal-Bench 4.0-AA | 57,1 | 52,0 | 52,0 | 59,1 | 59,6 |
| DeepSWE 1.1 | 79,0 | 78,8 | 67,4 | 74,1 | 74,2 |
| SWE-Marathon | 57,5 | 53,1 | 45,6 | 42,5 | 46,3 |
| ProgramBench | 59,0 | 50,0 | 55,5 | 52,5 | 70,5 |
| Artificial Analysis Index | 56 | 52 | 53 | 53 | 58 |
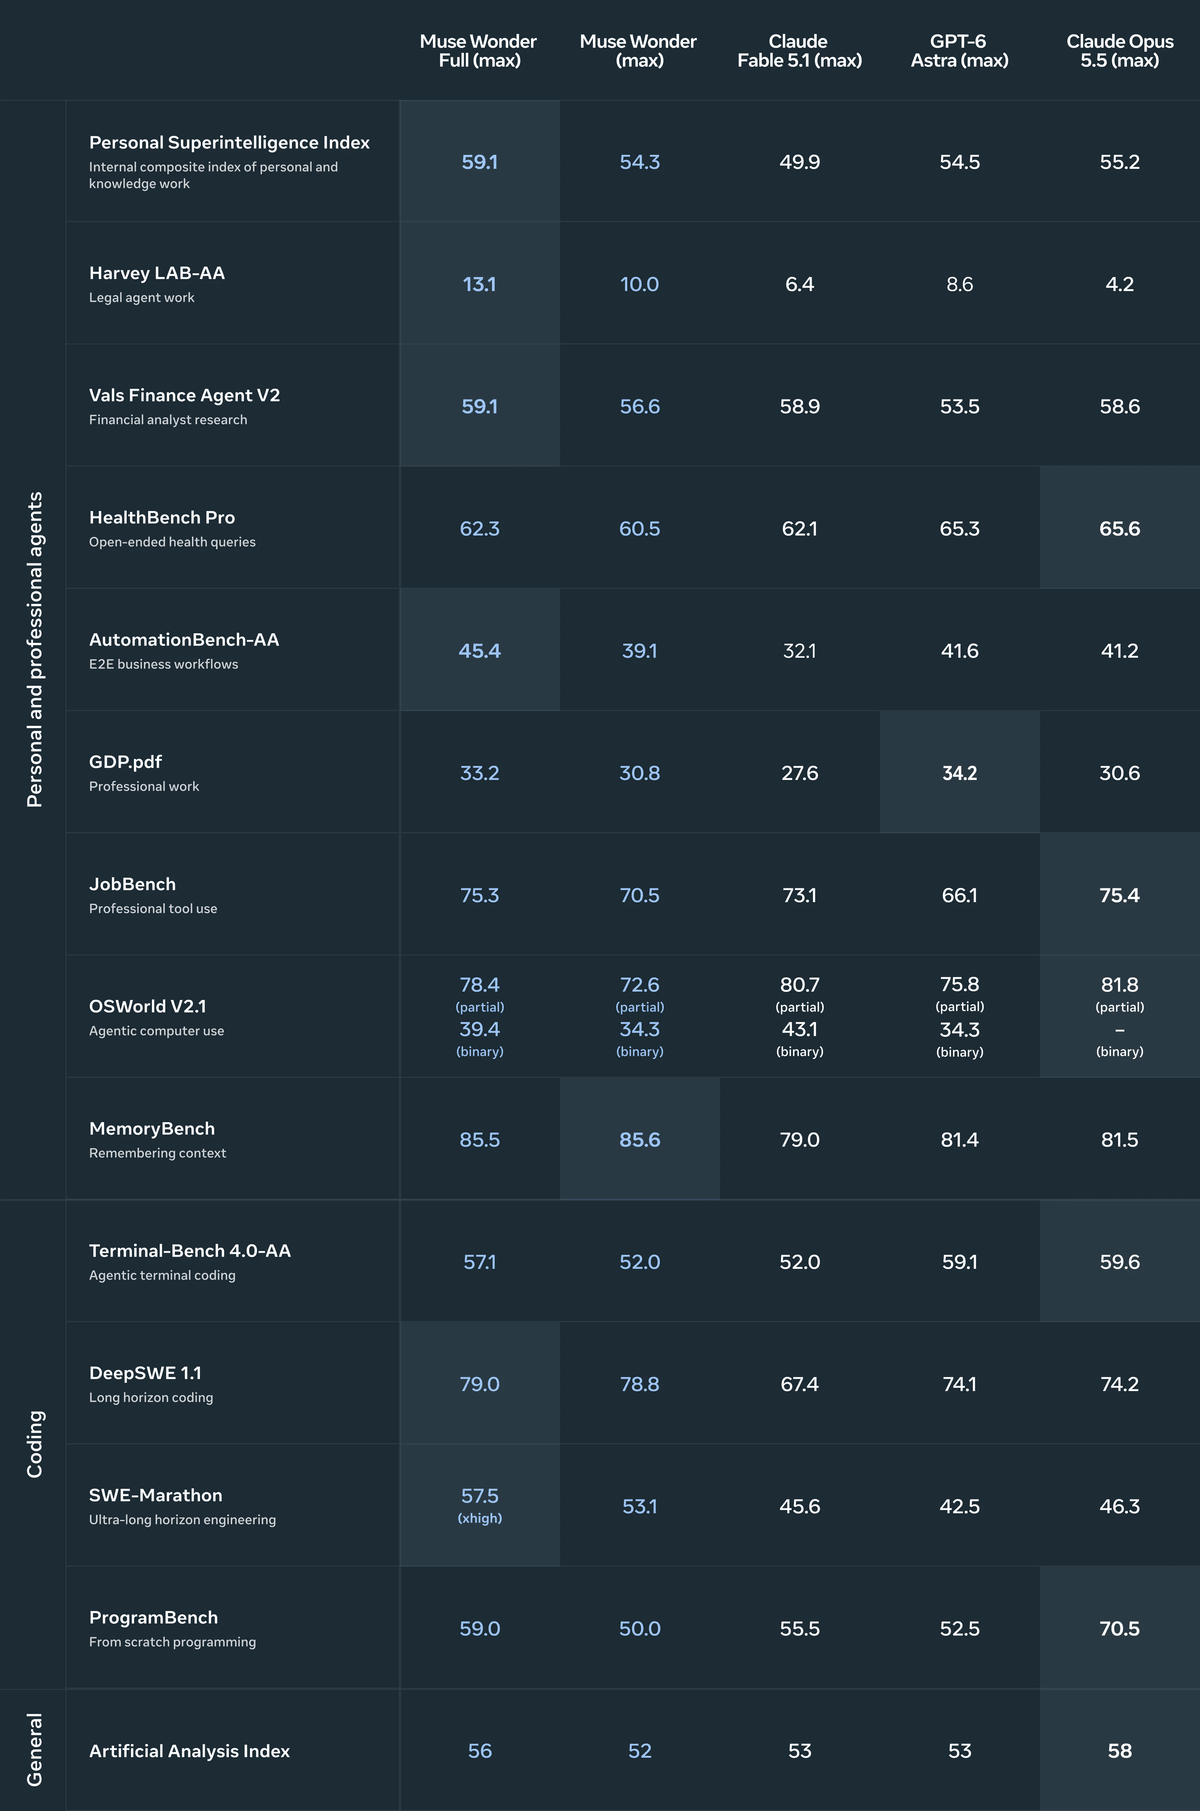
W oryginalnej tabeli Mety widać to od razu: większość podświetlonych pól należy do wersji Full, a nie do modelu, który kupisz w API. Zwykły Muse Wonder wygrywa z Opusem 5.5 w prawie (Harvey), w długich zadaniach programistycznych (DeepSWE, SWE-Marathon) i w zapamiętywaniu długich rozmów. Opus 5.5 jest lepszy w kodowaniu w terminalu, w pisaniu programu od zera (70,5 do 50,0 w ProgramBench), w obsłudze komputera, w odpowiedziach na pytania medyczne i w zbiorczym indeksie.
Trzy przypisy z karty modelu warto znać, zanim zaczniesz cytować te liczby:
- Dwa testy są wewnętrzne. Personal Superintelligence Index i MemoryBench to benchmarki Mety, których nikt z zewnątrz nie powtórzy.
- SWE-Marathon nie jest porównaniem na równych warunkach. Wyniki Astry i Fable pochodzą z Codexa i Claude Code, a Wonder Full był uruchomiony na poziomie
xhigh. Meta sama zaznacza, że ten wiersz nie powstał we wspólnym środowisku. - Wyniki konkurentów to „best-effort”. Gdy nie było wyniku od producenta albo niezależnej firmy, Meta wybierała najwyższy wynik spośród własnych testów, wyników deklarowanych przez producentów i rankingów. Przyznaje też, że prompty i narzędzia mogły nie być optymalnie dostrojone do modeli konkurencji.
Niezależne wyniki: Artificial Analysis, LMArena, Vals
Artificial Analysis daje Muse Wonderowi 52 punkty w Intelligence Index v4.3 (wersja Full: 56). Opus 5.5 ma 58, a Fable 5.1, GPT-6 Astra i Gemini 4 Argon po 53. Poprzednik, Muse Spark 1.3, miał 48.
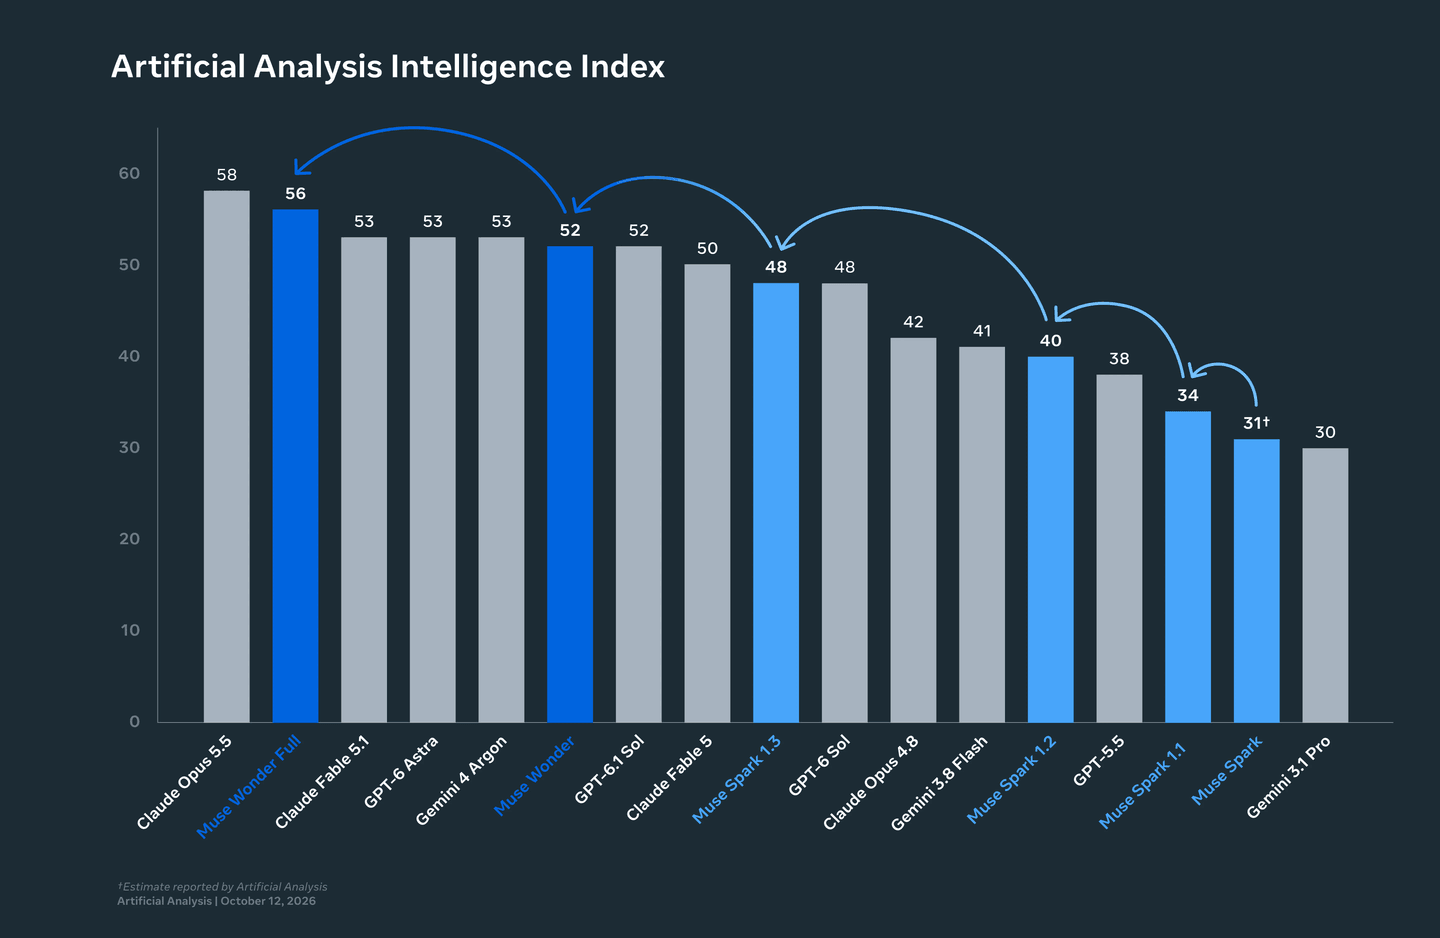
Na wykresie z wpisu Mety dobrze widać tempo: od pierwszego Muse Spark (według szacunku AA 31 punktów) do Wondera Full (56) modele Mety niemal podwoiły wynik, ale na szczycie wciąż stoi Opus 5.5.
Najciekawsze dane AA dotyczą wiedzy i halucynacji. W teście AA-Omniscience Muse Wonder ma 25 punktów, tyle co Spark 1.3, wobec 46 u Opusa 5.5 i 43 u Astry. Zarazem halucynuje w 27% przypadków, co daje mu trzecie miejsce wśród najmniej zmyślających modeli z wynikiem co najmniej 45 w indeksie. Te dwie liczby trzeba czytać razem: model nie wie więcej od konkurentów, częściej za to przyznaje, że czegoś nie wie, zamiast zgadywać. AA nazywa wiedzę jego względną słabością, łagodzoną niskim odsetkiem halucynacji.
W testach agentów do kodowania AA ocenia model razem ze środowiskiem, w którym pracuje. Muse Code z Wonderem Full ma 68 punktów w Coding Agents Index, Claude Code z Opusem 5.5 ma 66, a Muse Code ze zwykłym Wonderem 63.
LMArena, gdzie ludzie głosują na lepszą z dwóch anonimowych odpowiedzi, stawia Muse Wonder (Max) na 2. miejscu w rankingu tekstowym z wynikiem 1509, tuż za Gemini 4 Argon (1524) i punkt przed Opusem 5.5 (1508). Różnica do Opusa mieści się jednak w granicach błędu. W rankingu WebDev, czyli w budowaniu stron i aplikacji, jest gorzej: Muse Wonder ma 1651 punktów i 15. miejsce, a prowadzi Opus 5.5 (1811) przed GPT-6 Astrą (1780).
Vals Index, który ocenia zadania z zakresu finansów, prawa, podatków i kodowania, daje Opusowi 5.5 66,97%, Fable 5.1 65,83%, Wonderowi Full 64,57%, Astrze 63,13%, a zwykłemu Wonderowi 61,06%. Za to koszt jednego przebiegu testu wyniósł u Wondera 11,43 USD, u Opusa 32,14 USD.
Uwaga na nazwy: AutomationBench, ProgramBench czy testy dokumentów biznesowych występują u Mety, AA i Vals w różnych wersjach i z różnymi metrykami. Liczb z jednej tabeli nie porównuj z liczbami z drugiej.
Ile kosztuje Muse Wonder na tle konkurencji
Ceny API za milion tokenów, w USD:
| Model | Wejście | Wejście z cache | Wyjście | Długi kontekst |
|---|---|---|---|---|
| Muse Wonder | 4,00 | 0,20 | 20,00 | bez dopłaty do 1 mln |
| Claude Opus 5.5 | 4,00 | 0,20 | 20,00 | bez dopłaty do 1 mln |
| Claude Fable 5.1 | 10,00 | 0,25 | 50,00 | bez dopłaty do 1 mln |
| GPT-6 Astra | 10,00 | 1,00 | 50,00 | powyżej 272 tys. tokenów: 2x wejście i 1,5x wyjście za całe zapytanie |
Muse Wonder i Opus 5.5 mają identyczne stawki za token, a Fable 5.1 i Astra są 2,5 raza droższe. Rachunek zależy jednak od tego, ile tokenów model zużyje. Według Artificial Analysis jedno zadanie z indeksu tej firmy kosztuje z Muse Wonderem 4,52 USD, z Opusem 5.5 5,98 USD, z Fable 5.1 7,63 USD, a z Astrą 3,26 USD. Najmniej kosztuje zadanie z Astrą, mimo wysokiej stawki, bo zużywa znacznie mniej tokenów: na wyjściu około 27 tys. na zadanie wobec 54 tys. u Wondera. Wonder wypada taniej od Opusa, choć AA zwraca uwagę, że wczytuje dużo danych wejściowych.
Abonamenty i odnawianie limitów
Jeśli wolisz stałą opłatę zamiast płacenia za tokeny, Meta sprzedaje Muse Wondera w subskrypcji Muse Code, czyli agenta do kodowania w terminalu.
| Plan Muse Code | Cena miesięcznie | Limit | Muse Wonder Full |
|---|---|---|---|
| Everyday Usage | 5 USD | 10-50 poleceń co 5 godzin | nie |
| High Usage | 15 USD | 5x Everyday | nie |
| Power Usage | 50 USD | 20x Everyday | tak |
| Maximum Usage | 200 USD | 80x Everyday | tak |
Limity odnawiają się co pięć godzin, a niezależnie od tego co tydzień, i ten schemat obowiązuje we wszystkich planach. Gdy wyczerpiesz limit, możesz przejść na wyższy plan albo poczekać na odnowienie limitu, a w planie Maximum zostaje tylko czekanie. Subskrypcja działa wyłącznie w Muse Code, a każdy dodatkowy klucz API rozliczany jest już za tokeny.
Dla porównania: Claude Pro kosztuje 20 USD miesięcznie i obejmuje Opusa 5.5, a Fable 5.1 tylko w ramach dokupowanych kredytów. Plany Max (od 100 USD) pozwalają korzystać z Fable w ramach połowy tygodniowego limitu. U Anthropic też obowiązuje pięciogodzinne okno plus limit tygodniowy. W ChatGPT GPT-6 Astra jest dostępna w Work i Codex w planach Plus i Pro, z orientacyjnym limitem 5-45 wiadomości na pięć godzin w Plus. Plany Pro za 100, 200 i 500 USD nie mają w Work i Codex limitu pięciogodzinnego, choć ogólny limit użycia nadal obowiązuje. Więcej o subskrypcjach Claude’a w poradniku o cenach Claude Code.
Dostęp z Polski krok po kroku
Polska nie figuruje na liście 21 terytoriów wyłączonych w polityce geograficznej Meta Model API (są na niej m.in. Rosja, Białoruś, Chiny i Iran). Masz cztery drogi.
1. OpenRouter (najprostsza). Na nim przeprowadziłem test.
- Załóż konto na openrouter.ai i doładuj saldo kartą.
- W ustawieniach utwórz klucz API.
- Wybierz model
meta/muse-wonder. Cena jest taka sama jak u Mety: 4 USD i 20 USD za milion tokenów.
Jak podpiąć jeden klucz do różnych narzędzi, opisałem w poradniku o OpenRouterze.
2. Meta Model API (bezpośrednio).
- Wejdź na dev.meta.ai i wybierz „Start building”, a potem konto „Individual” (logowanie przez e-mail, telefon, Google, GitHub lub Facebooka; trzeba mieć 18 lat).
- W zakładce Billing dodaj metodę płatności. Bez niej nie wyślesz pierwszego zapytania.
- W zakładce API keys utwórz klucz i wywołuj model
muse-wonder-1.0pod adresemhttps://api.meta.ai/v1. API jest zgodne z SDK OpenAI i Anthropic, więc większość narzędzi podepniesz, zmieniając adres i klucz.
3. Cursor. W Cursorze Muse Wonder ma 300 tys. tokenów kontekstu, a w trybie Max Mode milion, przy tych samych stawkach. Nie wchodzi w pulę zawartą w abonamencie: w nowych planach The X Subscription płacisz za niego z przedpłaconego kredytu (o zmianach w cenniku Cursora pisałem tutaj), a w starych planach z puli na modele innych firm.
4. Muse Code (abonament). Instalujesz go jednym poleceniem w terminalu, logujesz się kontem Meta i wykupujesz plan przez Centrum kont. Zanim zaczniesz pierwszy projekt, wpisz w Muse Code /settings i wyłącz tryb Contributor. W subskrypcjach jest on domyślnie włączony i oznacza, że Meta może używać twoich promptów, kodu, plików i odpowiedzi modelu do trenowania kolejnych modeli. W zamian dostajesz większy limit, więc po wyłączeniu limit spadnie. W płatnym API Muse Wonder działa tylko w trybie standardowym, bez użycia danych do trenowania.
Konsumencka aplikacja Muse, do której Muse Wonder ma trafić najpierw dla subskrybentów, wystartowała w USA i Meta nie ogłosiła jej premiery w Europie. Meta nie publikuje też listy obsługiwanych języków. Karta modelu mówi tylko o szerokiej reprezentacji języków świata w danych treningowych i ostrzega, że jakość może być niższa w językach, które model obsługuje słabiej. Dlatego polski sprawdziłem sam.
Mój test po polsku
Wszystkie modele dostały te same trzy zadania po polsku przez OpenRoutera, na poziomie rozumowania high, w jednym przebiegu. W teście praktycznym zestawiłem Muse Wonder z Opusem 5.5 i GPT-6 Astrą, a Fable 5.1 pojawia się w tym tekście tylko w zestawieniach benchmarków i cen.
Zadanie 1: aplikacja z jednego polecenia
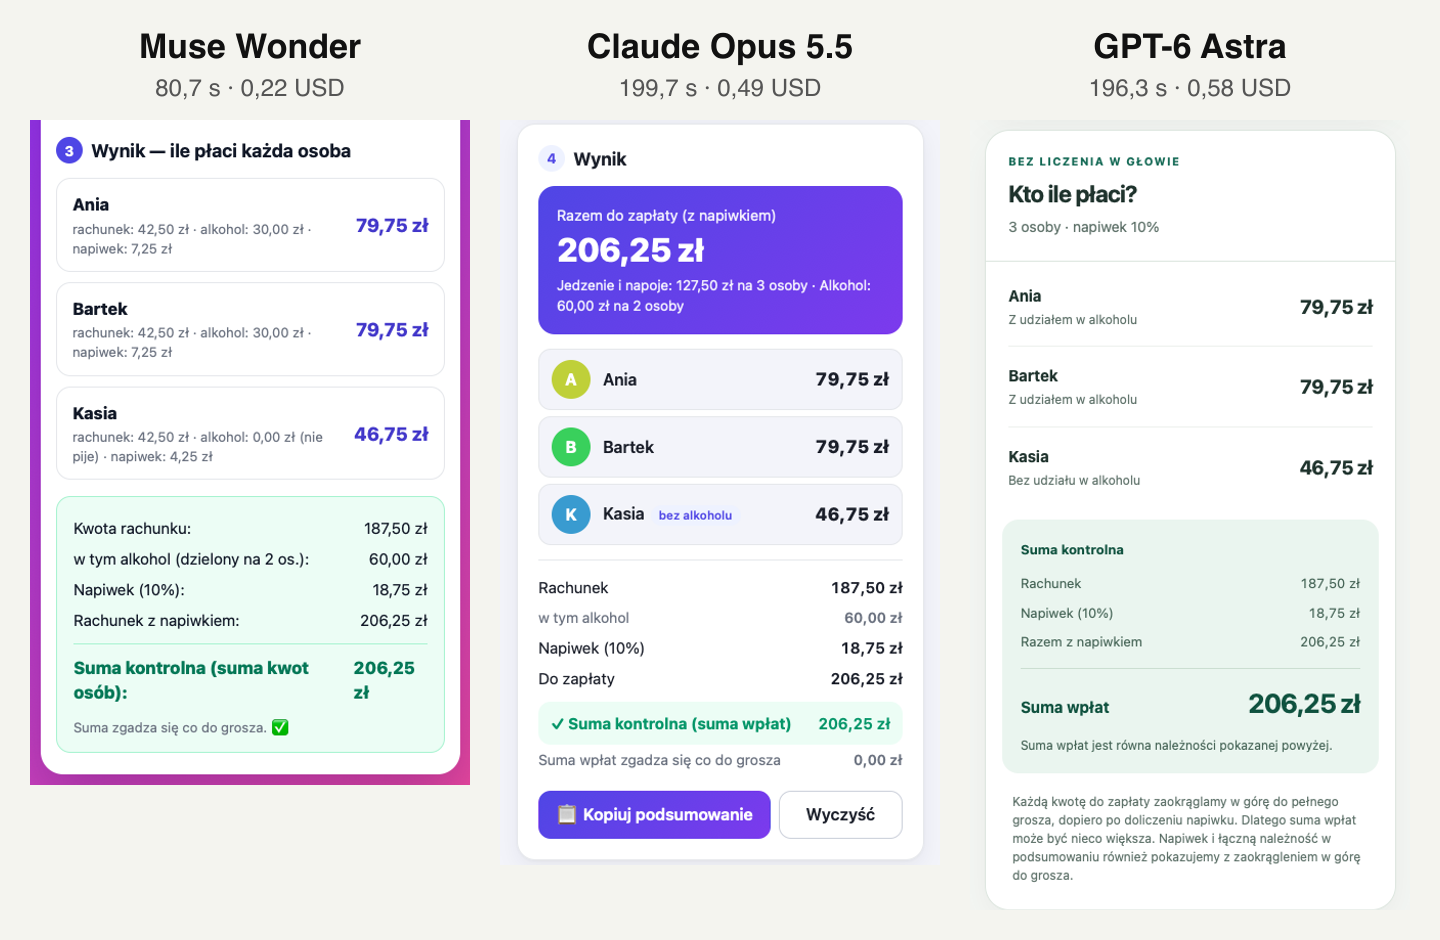
Poprosiłem o kalkulator „Podział rachunku” w jednym pliku HTML: kwoty z przecinkiem i kropką, napiwek 0, 10, 15% lub własny, lista osób, osobna pozycja na alkohol dzielona tylko między pijących, wynik zaokrąglony w górę do grosza z sumą kontrolną i komunikaty błędów po polsku. Każdą aplikację sprawdziłem w przeglądarce na tych samych danych: rachunek 187,50 zł, w tym 60 zł za alkohol, napiwek 10%, Ania i Bartek piją, Kasia nie.
| Muse Wonder | Opus 5.5 | GPT-6 Astra | |
|---|---|---|---|
| Wynik (79,75 / 79,75 / 46,75 zł) | poprawny | poprawny | poprawny |
| 100 zł na 3 osoby (zaokrąglenie) | 3 x 33,34 zł, nadwyżka wyjaśniona | poprawnie, nadwyżka opisana | poprawnie, nadwyżka opisana |
| Kwota ujemna | polski komunikat błędu | polski komunikat przy polu | polski komunikat błędu |
| Czas generowania | 80,7 s | 199,7 s | 196,3 s |
| Tokeny na wyjściu | 11 068 | 24 405 | 11 538 |
| Koszt | 0,22 USD | 0,49 USD | 0,58 USD |
Wszystkie trzy aplikacje policzyły wszystko poprawnie za pierwszym razem, więc różnice dotyczą czasu, kosztu i wygody. Muse Wonder zrobił to najszybciej i najtaniej, bo przy tej samej stawce co Opus zużył ponad dwa razy mniej tokenów. Opus przy pierwszym podejściu przekroczył mój limit 24 tys. tokenów i uciął plik, więc powtórzyłem próbę z wyższym limitem. Za to jego aplikacja liczy wynik na żywo, bez przycisku, i ma przycisk kopiowania podsumowania. Muse Wonder wpisał od razu przykładowe dane (Ania, Bartek, niepijąca Kasia), wygodne do pokazu, ale przed prawdziwym użyciem trzeba je wyczyścić.
Zadanie 2: polska gramatyka sprawdzana automatycznie
Modele napisały funkcje do odmiany rzeczowników po liczebnikach (1 plik, 2 pliki, 5 plików) i do zapisu kwoty słownie, jak na fakturze: „tysiąc dwieście trzydzieści cztery złote 56/100”. Sprawdziłem je skryptem na 30 przypadkach, od 12 i 22 po 999 999 999,99 i klasyczną pułapkę 0,1 + 0,2.
| Muse Wonder | Opus 5.5 | GPT-6 Astra | |
|---|---|---|---|
| Zaliczone przypadki | 30/30 | 30/30 | 30/30 |
| Czas | 24,1 s | 26,4 s | 38,6 s |
| Koszt | 0,08 USD | 0,07 USD | 0,09 USD |
Polskie liczebniki przestały być problemem dla czołowych modeli. Muse Wonder najdłużej się nad nimi zastanawiał: na rozumowanie poszło 3038 z jego 4101 tokenów.
Zadanie 3: wyjaśnienie błędu osobie nietechnicznej
Wcieliłem się w kogoś, kto zbudował aplikację w Lovable, wrzucił ją na GitHuba i nie może opublikować na Vercelu, bo build kończy się błędem „supabaseUrl is required”. Poprosiłem o wyjaśnienie na „ty”, w maksymalnie 200 słowach.
| Muse Wonder | Opus 5.5 | GPT-6 Astra | |
|---|---|---|---|
| Długość | 130 słów | 167 słów | 183 słowa |
| Czas / koszt | 36,0 s / 0,08 USD | 15,8 s / 0,04 USD | 22,8 s / 0,05 USD |
| Diagnoza | trafna | trafna, z wyjaśnieniem przyczyny | trafna |
Wszystkie trzy wskazały, że Vercel nie zna adresu i klucza Supabase. Muse Wonder napisał to najprościej, bez żargonu, w siedmiu krokach do wyklikania. Zaczął od zdania, że aplikacja „nie zna adresu miejsca, w którym trzyma swoje dane”. Z góry założył jednak konkretne nazwy zmiennych, nie sprawdzając ich w projekcie, i nie ostrzegł przed wklejaniem tajnego klucza. Opus jako jedyny wyjaśnił, skąd problem: w Lovable dane były ustawione automatycznie, ale nie trafiły na GitHuba. Astra była najdokładniejsza i jako jedyna wprost przestrzegła przed użyciem klucza service_role, ale użyła najwięcej technicznych terminów.
Podsumowanie testu
| Muse Wonder | Opus 5.5 | GPT-6 Astra | |
|---|---|---|---|
| Zadania zaliczone | 3/3 | 3/3 | 3/3 |
| Łączny czas | 141 s | 242 s | 258 s |
| Łączny koszt | 0,38 USD | 0,59 USD | 0,72 USD |
W prostych, realnych zadaniach po polsku nie widziałem różnicy w jakości: wszystkie trzy modele sobie poradziły. Muse Wonder był najszybszy i najtańszy, a w zadaniu, które kosztuje najwięcej, czyli w budowie aplikacji, różnica była ponad dwukrotna. Wyjaśniał najprostszym językiem, ale był też najmniej ostrożny. Pamiętaj o ograniczeniach: to jeden przebieg, trzy zadania i poziom high. Przewaga Opusa w Terminal-Bench i ProgramBench dotyczy dłuższych i trudniejszych zadań, których ten test nie obejmuje.
Werdykt: dla kogo Muse Wonder
- Muse Wonder: jeśli budujesz proste i średnie aplikacje, prototypy albo automatyzacje i płacisz za tokeny. Daje jakość z czołówki przy stawkach Opusa, a w praktyce kosztuje mniej, bo zużywa mniej tokenów. Dobrze radzi sobie z polskim i rzadziej zmyśla, gdy czegoś nie wie.
- Claude Opus 5.5: jeśli pracujesz nad dużym, istniejącym projektem, potrzebujesz agenta w terminalu albo budujesz interfejsy. Tu Opus wygrywa w benchmarkach Mety, AA, Vals i w WebDev Arenie. Przy abonamencie Claude Pro za 20 USD masz go w pakiecie z Claude Code. Więcej o nim w newsie o premierze Opusa 5.5.
- Claude Fable 5.1 i GPT-6 Astra: w API kosztują 2,5 raza więcej za token, a w niezależnych indeksach osiągają wyniki zbliżone do Muse Wondera, bez wyraźnej przewagi. Jeśli nie programujesz, a chcesz budować aplikacje, nie widzę powodu, żeby dopłacać. Astra ma sens dla abonentów ChatGPT, którzy i tak płacą za Plus lub Pro, a Fable dla abonentów Claude Max, którzy mają go w planie (o premierze Fable 5.1 pisałem tutaj).
- Muse Wonder Full: najmocniejszy z rodziny i najczęściej podświetlany w tabeli Mety, ale tylko w Muse Code od 50 USD miesięcznie. Ma sens, jeśli i tak chcesz pracować w terminalu i akceptujesz domyślny tryb Contributor albo mniejszy limit po jego wyłączeniu.
Na start polecam OpenRoutera: kilka dolarów salda wystarczy, żeby sprawdzić Muse Wondera na własnym projekcie i porównać go z Opusem przy tym samym poleceniu.
Najczęstsze pytania
Ile kosztuje Muse Wonder?
W Meta Model API i na OpenRouterze Muse Wonder kosztuje 4 USD za milion tokenów na wejściu, 0,20 USD za tokeny z cache i 20 USD za milion tokenów na wyjściu, bez dopłaty za długi kontekst. To dokładnie tyle samo co Claude Opus 5.5. W subskrypcji Muse Code model jest dostępny od planu za 5 USD miesięcznie, a mocniejszy Muse Wonder Full od planu Power za 50 USD.
Czy Muse Wonder działa w Polsce?
Tak, przez API. Polski nie ma na liście terytoriów wyłączonych w polityce geograficznej Meta Model API, a model jest też dostępny na OpenRouterze i w Cursorze. Test przeprowadziłem przez OpenRoutera z polskiego konta. Konsumencka aplikacja Muse wystartowała w USA i Meta nie ogłosiła jej premiery w Europie.
Czy Muse Wonder jest lepszy od Claude Opus 5.5?
Nie w kodowaniu. Opus 5.5 wygrywa w Terminal-Bench i ProgramBench według samej Mety, prowadzi w indeksie Artificial Analysis (58 do 52) i w rankingu WebDev Arena. Muse Wonder za tę samą cenę za token zużywa jednak mniej tokenów, więc typowe zadanie wychodzi taniej. W moim teście po polsku oba modele zbudowały poprawną aplikację, a Muse Wonder zrobił to szybciej i za mniej niż połowę ceny Opusa.
Czym się różni Muse Wonder od Muse Wonder Full?
Muse Wonder Full to mocniejszy wariant, dostępny wyłącznie w subskrypcji Muse Code, w planach Power za 50 USD i Maximum za 200 USD miesięcznie. Zwykły Muse Wonder jest w API, na OpenRouterze, w Cursorze i w każdym planie Muse Code. Większość rekordów z tabeli Mety należy do wersji Full.
Opanuj AI‑coding w 5 minut. W każdy poniedziałek.
Konkretne premiery, analizy cen i jeden trik, który przyspieszy Twoją pracę. Po polsku, bez żargonu, prosto na maila.