Gemini 4 Argon vs GPT-6 Astra: kto wygrywa?
Gemini 4 Argon wygrywa w 13 z 19 testów Google, a w Vibe Code Bench buduje aplikację za 8 USD, Opus 5.5 za 58 USD. Kiedy dostęp i ile kosztuje API.
Google DeepMind pokazał 30 września Gemini 4 Argon, najmocniejszy model w historii Gemini. W zestawieniu Google model wygrywa z GPT-6 Astrą, Claude Fable 5.1 i Claude Opusem 5.5 w 13 z 19 testów, a w jednym remisuje. Największą przewagę ma w automatyzacji pracy biurowej, przy bardzo długich dokumentach i w analizie wideo. Przegrywa w pięciu testach, w tym w kodowaniu agentowym w terminalu (agent sam wpisuje polecenia w wierszu poleceń), gdzie prowadzi Opus 5.5. Na razie nie użyjesz go jednak ani w aplikacji Gemini, ani przez API: Google udostępnił model tylko swoim pracownikom i partnerom programu Fairwind.
W czym Gemini 4 Argon jest lepszy od konkurencji
Google porównał Argona z najmocniejszymi modelami OpenAI i Anthropic w 19 benchmarkach. Największą przewagę Argon ma w tych testach:
- Automatyzacja pracy biurowej: w AutomationBench od Zapiera, który sprawdza, czy agent wykona firmowe zadanie w kilku aplikacjach naraz, Argon ma 51,3 procent wobec 42,5 procent Opusa 5.5 i 41,4 procent Astry. W teście agenta finansowego Vals Finance Agent v2 wynik to 65,4 procent wobec 58,9 procent Fable 5.1.
- Zadania prawnicze: w benchmarku agenta prawniczego firmy Harvey Argon ma 19,6 procent, a rywale od 3,8 do 6,7 procent. Przewaga jest kilkukrotna, choć sam poziom wciąż jest niski.
- Długie dokumenty: w teście GraphWalks, na tekstach od 256 tysięcy do miliona tokenów, Argon ma 84,2 procent, Astra 71,8, a Opus 5.5 66,8 procent. Ten test sprawdza, czy model naprawdę korzysta z całego okna kontekstu, a nie tylko z jego początku i końca.
- Wideo: w LVBench, gdzie model odpowiada na pytania o długie nagrania, Argon ma 91,7 procent wobec 87,5 procent Astry.
- Długie zadania programistyczne: w DeepSWE v1.1 Argon ma 77,9 procent, o 3,7 punktu procentowego więcej niż Opus 5.5 (74,2) i o 3,8 więcej niż Astra (74,1).
Do tego dochodzi limit odpowiedzi. Argon może wygenerować w jednej odpowiedzi do miliona tokenów, podczas gdy poprzednie modele Gemini mogły wygenerować do 64 tysięcy, a Opus 5.5 i Astra do 128 tysięcy. Przy generowaniu dużych plików albo całych modułów aplikacji rzadziej trzeba więc dzielić zadanie na części.
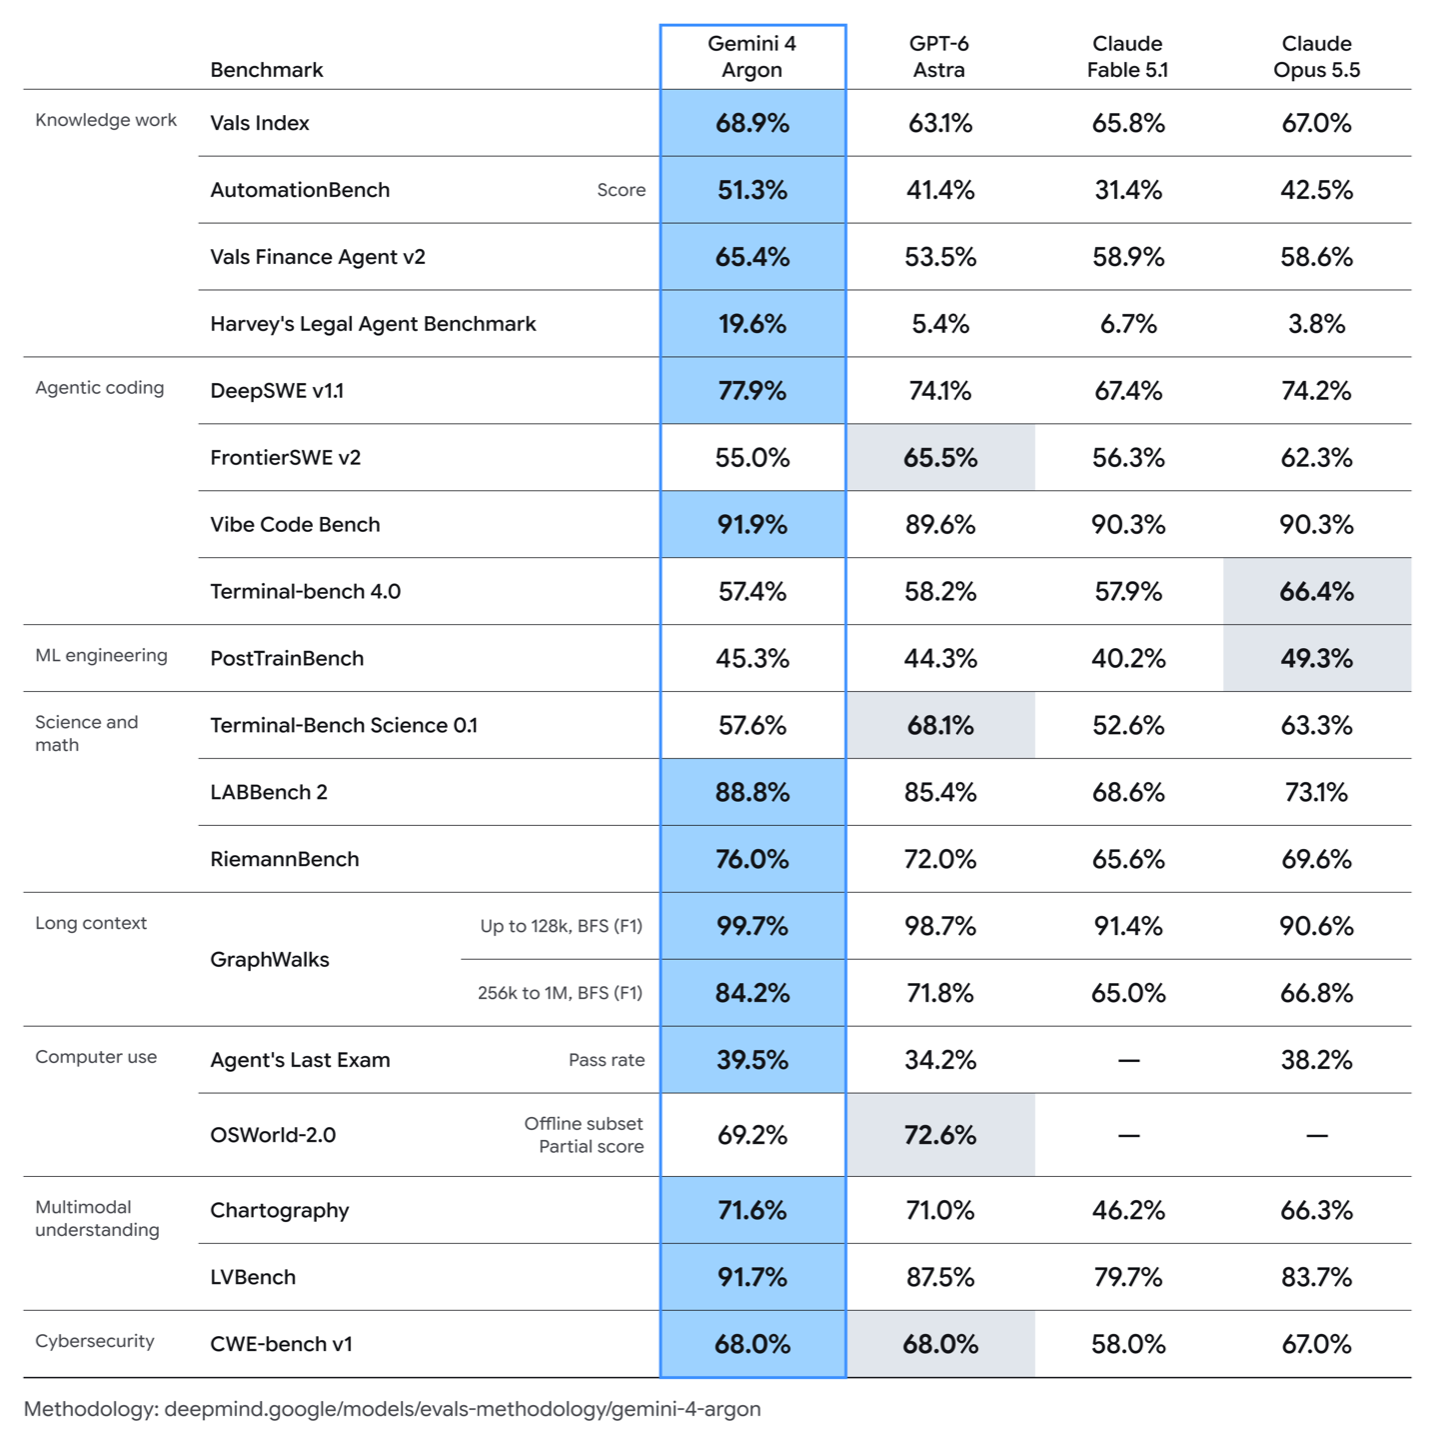
Niebieskie pola to wygrane Argona, szare to testy, w których prowadzi rywal.
Gdzie Argon przegrywa
- Terminal-Bench 4.0 (kodowanie agentowe w terminalu): 57,4 procent wobec 66,4 procent Opusa 5.5. Astra ma 58,2, a Fable 5.1 57,9 procent.
- FrontierSWE v2: 55,0 procent, podczas gdy Astra ma 65,5, a Opus 5.5 62,3 procent.
- PostTrainBench (dotrenowywanie modeli): 45,3 wobec 49,3 procent Opusa 5.5.
- Terminal-Bench Science: 57,6 wobec 68,1 procent Astry.
- OSWorld-2.0 (obsługa komputera przez agenta): 69,2 wobec 72,6 procent Astry.
Według metodologii DeepMind Argona testowano z najwyższym poziomem rozumowania, wyniki rywali pochodzą głównie z danych ich producentów, a część wyników Argona, w tym DeepSWE i Terminal-Bench 4.0, Google policzył sam. Porównanie przygotował więc producent modelu i nie jest to niezależny test.
Vibe Code Bench: niezależny test budowania aplikacji
Dla budujących aplikacje najciekawszy jest wynik z Vibe Code Bench, który prowadzi niezależna firma Vals AI. Model dostaje jednostronicowy opis aplikacji webowej napisany zwykłym językiem i do pięciu godzin na zbudowanie jej od zera, z bazą danych Supabase i płatnościami Stripe w trybie testowym, czyli bez prawdziwych pieniędzy. Potem automatyczny tester klika aplikację jak użytkownik i sprawdza, czy działa logowanie, formularze i reszta funkcji.
W rankingu z 29 września Argon ma 91,9 procent i zajmuje drugie miejsce. Wyprzedza go tylko Claude Sonnet 5.5 z wynikiem 92,4 procent, wydany przez Anthropic 28 września, którego Google nie umieścił w swojej tabeli. Opus 5.5 ma 90,3, a Astra 89,6 procent. Te różnice mieszczą się w granicach błędu pomiaru, który Vals podaje przy każdym wyniku (dla Argona to plus minus 1,9 punktu), więc pod względem jakości to praktycznie remis.
Wyraźnie różnią się za to koszt i czas. Według Vals zbudowanie jednej aplikacji przy użyciu Argona kosztowało 8,11 USD i trwało średnio 37 minut. Opus 5.5 potrzebował 57,92 USD i 96 minut, Astra 38,51 USD, a Sonnet 5.5 31,25 USD i około godziny. Vals liczy koszt Argona według stawki docelowej, takiej samej jak cena Opusa 5.5, więc przewaga bierze się z tego, że Argon zużywa na zadanie kilka razy mniej tokenów. Przy cenie wprowadzającej koszt aplikacji spadłby jeszcze o połowę.
Ile kosztuje Gemini 4 Argon w API
Google ustalił cenę wprowadzającą: 2 USD za milion tokenów na wejściu i 10 USD na wyjściu. Wejście to wszystko, co wysyłasz do modelu, a wyjście to jego odpowiedź. Tokeny czytane z pamięci podręcznej (cache), czyli treść już raz przetworzona, na przykład ten sam kod wysyłany przy każdym kroku agenta, są o 95 procent tańsze i kosztują 0,10 USD. Po okresie promocyjnym stawki wzrosną do 4 i 20 USD, tyle samo co za Opusa 5.5. Astra kosztuje 10 i 50 USD, więc nawet po podwyżce Argon będzie od niej dwa i pół raza tańszy. Cena wprowadzająca jest tymczasowa, dlatego w budżecie projektu licz od razu 4 i 20 USD.
Kiedy dostęp i co z abonamentem Google AI
Na razie z Argona korzystają tysiące pracowników Google i partnerzy programu Fairwind, czyli ponad 650 organizacji: rządy i krajowe agencje cyberbezpieczeństwa, operatorzy infrastruktury krytycznej (ochrona zdrowia, telekomunikacja, energetyka, finanse) i duże platformy technologiczne. Dostają model do wykrywania luk i automatycznego łatania kodu. Google tłumaczy stopniowe wdrażanie bezpieczeństwem: model o takich możliwościach wymaga mocniejszych zabezpieczeń przed nadużyciami i atakami typu prompt injection. Firma bierze też udział w dobrowolnej procedurze, w której rząd USA dostaje dostęp do modeli przed premierą.
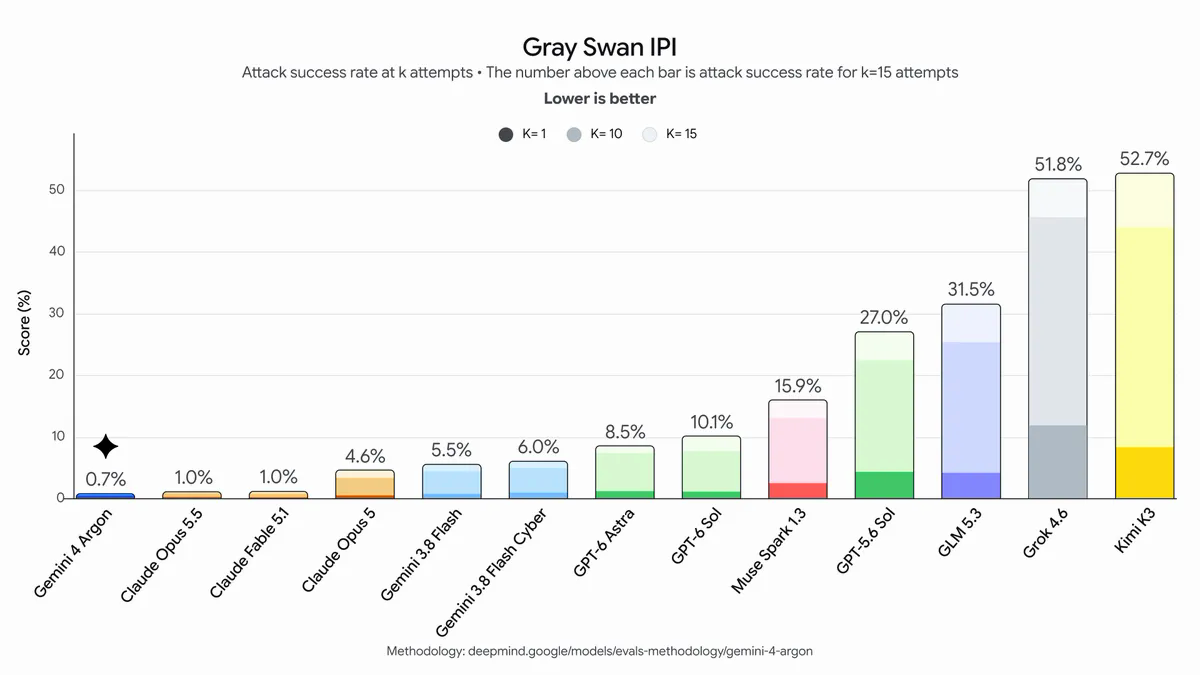
W teście Gray Swan atakujący ukrywa polecenia w treściach, które czyta agent (na stronach, w plikach, w mailach), żeby nakłonić go do działań, o które nikt go nie prosił. Ma na to 15 prób. Atak powiódł się w 0,7 procent prób przeciwko Argonowi, w 1,0 procent przeciwko Opusowi 5.5 i w 8,5 procent przeciwko Astrze. Gdy agent ma dostęp do plików i poczty, ta liczba waży więcej niż większość benchmarków (więcej o tym zagrożeniu w tekście o prompt injection w Claude Code).
Następni w kolejce są płatni klienci API i abonenci Google AI Ultra, najdroższego planu Google AI. Google zapowiada, że model trafi do nich „tak szybko, jak to możliwe”, a planów Plus i Pro w tej zapowiedzi nie wymienia. W aplikacji Gemini limit użycia w płatnych planach odnawia się co pięć godzin, aż do wyczerpania limitu tygodniowego. Dla porównania Opus 5.5 działa na każdym płatnym planie Claude i jest domyślnym modelem w Claude Code, a Astrę znajdziesz w Codeksie i ChatGPT Work na płatnych planach OpenAI, najszerzej w planie Pro.
Co to znaczy dla vibe codingu
Na razie w twoich narzędziach nic się nie zmienia, bo Argona nie wybierzesz w żadnym z nich. Do budowania aplikacji od zera najlepszy wynik w Vibe Code Bench ma teraz Claude Sonnet 5.5 za 2 i 10 USD, a w długich sesjach agenta w terminalu, migracjach i refaktorach prowadzi Opus 5.5.
Gdy Argon trafi do API, sprawdź go przy dwóch rodzajach pracy. Pierwszy to generowanie całych aplikacji z opisu, gdzie według Vals jest kilka razy tańszy i wyraźnie szybszy od modeli Claude przy podobnej jakości. Drugi to praca na dużych projektach i długich dokumentach, gdzie przydają się analiza bardzo długich materiałów i bardzo długie odpowiedzi. W testach terminalowych wypada słabiej, więc do pracy agenta w wierszu poleceń Opus 5.5 zostaje mocniejszym wyborem.
Opanuj AI‑coding w 5 minut. W każdy poniedziałek.
Konkretne premiery, analizy cen i jeden trik, który przyspieszy Twoją pracę. Po polsku, bez żargonu, prosto na maila.